
 346
 0
Хиймэл оюунаас нэг ижил асуулт англи, монгол хэлээр, аль эсвэл өөр аль ч хэлээр асуухад харилцан адилгүй зардал гардгийг та мэдэх үү? Бидний хувьд хэл гэдэг хиймэл оюунтай харилцах хэрэгсэл төдийхөн боловч мэдээлэл боловсруулах хурд, багтаамж, цаашлаад үйлчилгээний өртөгт хүртэл нөлөөлдөг чухал хүчин зүйл ажээ.
Саяхан нийтлэгдсэн нэгэн судалгаагаар ижил утгатай мэдээллийг боловсруулахад шаардлагатай нөөц хэл бүрд ихээхэн ялгаатай байгааг тогтоожээ. Тэгвэл энэ ялгаа юунаас үүдэлтэй, бидэнд ямар хамаатай, хиймэл оюуныг илүү үр ашигтай ашиглахын тулд юуг анхаарах хэрэгтэй вэ? Хамгийн гол нь яаж бага токен зарцуулах вэ?
ХЭЛНЭЭС ҮҮДЭЛТЭЙ ҮЛ ҮЗЭГДЭХ ТАТВАР
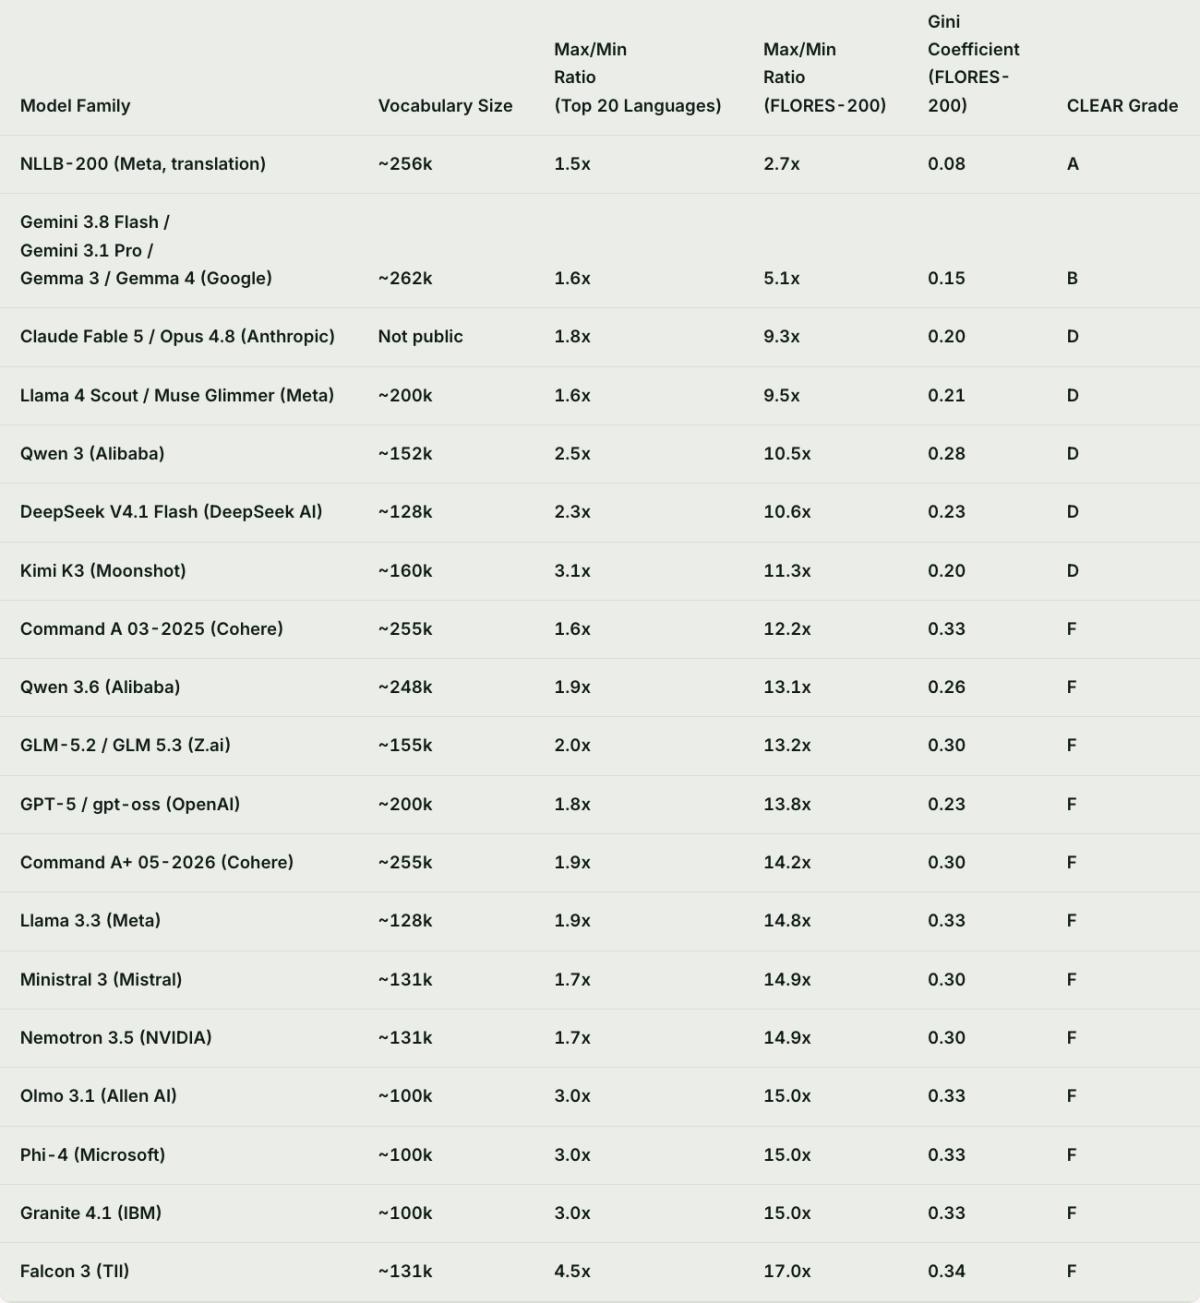
Өнгөрсөн есдүгээр сард хиймэл оюуны салбар дахь хэлний тэгш байдлыг судалдаг Coalition for Language Equity in AI Research (CLEAR) байгууллагаас “The Tokenizer Tax” нэртэй судалгааг танилцуулав. Тэд томоохон технологийн компаниудын хөгжүүлсэн хиймэл оюуны 19 загварын бүлгийг 203 хэл-бичгийн хувилбартай харьцуулан судалсан бөгөөд үр дүнд нь нэг ижил мэдээллийг боловсруулахад зарцуулах токены тоо хэл бүрд ихээхэн ялгаатай байгааг тогтоожээ.
Судлаачид энэхүү үзэгдлийг “Tokenizer Tax” буюу токенчлолын үл үзэгдэх татвар хэмээн нэрлэсэн байна. Энгийнээр тайлбарлавал, зарим хэл дээр хиймэл оюун ашиглахад бусад хэлнээс илүү олон токен шаарддаг тул нэмэлт зардал үүсэх боломжтой гэсэн үг юм.
Токен гэж юу болохыг эхлээд ойлгоё. Бид хиймэл оюунд асуулт, заавар бичихэд систем тухайн өгүүлбэрийг хүн шиг үг бүрээр нь уншдаггүй. Харин текстийг токен гэх жижиг нэгжүүдэд хуваан боловсруулдаг бөгөөд нэг токен нь бүтэн үг, үгийн хэсэг, цэг тэмдэг, зарим тохиолдолд ганц тэмдэгт ч байж болно.
Үүнийг CLEAR-ийн судалгаанд ашигласан нэгэн жишээгээр тайлбарлая. “Хүмүүс ямар хэлээр ярьдгаас үл хамааран хиймэл оюуны үр өгөөжийг хүртэх ёстой” гэсэн утгатай өгүүлбэрийг GPT-5 загварын токенчлолын системээр гурван өөр хэл дээр боловсруулахад дараах үр дүн гарчээ.
- Англи хэлээр 13 токен
- Малаялам хэлээр 26 токен
- Амхар хэлээр 78 токен
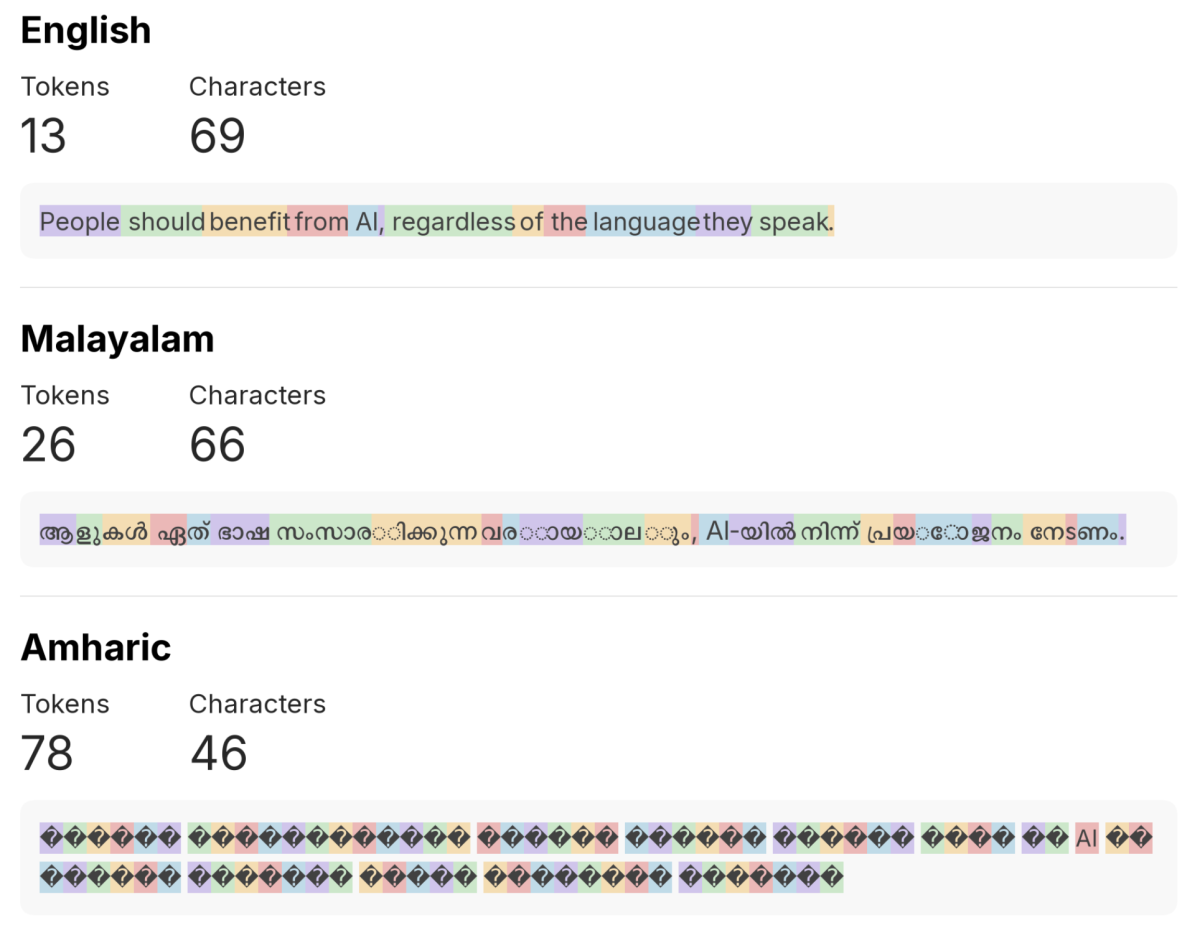
Ижил утгатай нэг өгүүлбэрийг амхар хэлээр боловсруулахад англи хэлнээс зургаа дахин олон токен шаардсан байна. Сонирхолтой нь, эдгээр өгүүлбэрийн тэмдэгтийн тоо ойролцоо төдийгүй малаялам болон амхар хэл дээрх хувилбарууд англи хэлнийхээс ч цөөн тэмдэгттэй байжээ. Энэ ялгаа зөвхөн дээрх гурван хэлээр хязгаарлагдахгүй. Судалгаанд хамрагдсан 203 хэл-бичгийн хувилбарыг харьцуулахад зарим загварын хамгийн өндөр болон бага токены хэрэглээ 17 дахин зөрүүтэй гарчээ. Харин цахим орчинд хамгийн өргөн хэрэглэгддэг 20 хэлний хувьд ихэнх загварын зөрүү 1.5-3.1 дахин байв.
ТЭГВЭЛ ЯАГААД ЗАРИМ ХЭЛ ИЛҮҮ ОЛОН ТОКЕН ШААРДДАГ ВЭ?
Үүний нэг шалтгаан нь токенчлолын системийг хөгжүүлэхэд ашигласан өгөгдлийн хэмжээ, бүтэцтэй холбоотой. Цахим орчин дахь мэдээллийн нөөц хэл бүрд харилцан адилгүй учраас токенчлолын систем түгээмэл хэлний үг, өгүүлбэрийг харьцангуй үр ашигтай хуваадаг байна. Харин өгөгдөл багатай хэлний хувьд нэг үгийг илүү олон жижиг хэсэгт задлах шаардлага үүсдэг аж.
Үүнээс гадна тухайн хэлний бичиг үсэг ч чухал нөлөөтэй. Тухайлбал, Испанийн Астури мужид хэрэглэгддэг астури хэл харьцангуй цөөн хэрэглэгчтэй ч латин үсэг ашигладаг, бусад роман хэлтэй төстэй бүтэцтэй учраас токенчлолын хувьд тодорхой давуу талтай байна. Харин бирм, төвөд, кхмер, лаос зэрэг өвөрмөц бичиг үсэгтэй хэлнүүд судалгаанд хамрагдсан олон загварт хамгийн үр ашиггүй боловсруулагддаг хэлнүүдийн тоонд багтжээ. Өөрөөр хэлбэл, хиймэл оюун олон зуун хэлээр харилцах боломжтой болсон ч тэдгээр хэлийг боловсруулах технологийн суурь нь бүгд ижил түвшинд хөгжөөгүй аж.
Токены хэрэглээ нь мөн хиймэл оюуны нэг дор боловсруулах мэдээллийн багтаамжид нөлөөлдөг. Загвар бүрийн context window буюу агуулгын багтаамж тодорхой хязгаартай учраас нэг хэлээр ижил мэдээллийг илүү олон токеноор илэрхийлдэг бол тухайн багтаамжид оруулах баримт бичиг, өмнөх харилцан ярианы хэмжээ багасна. Иймээс токеныг хэр үр ашигтай ашиглаж байгааг мэдэх нь зөвхөн хөгжүүлэгчдэд ч гэлтгүй хиймэл оюуныг өдөр тутмын хэрэглээндээ ашигладаг бидэнд хэрэгтэй юм.
ХИЙМЭЛ ОЮУНЫ ЗАГВАРУУД ХЭР ТЭГШ ҮЙЛЧИЛДЭГ ВЭ?
CLEAR-ийн зүгээс хиймэл оюуны загваруудыг хэл бүрд хэр тэгш үйлчилж буйгаар нь A-F хүртэл үнэлжээ. Ингэхдээ хамгийн их токен шаарддаг хэлийг хамгийн бага токен шаарддаг хэлтэй харьцуулсан бөгөөд зөрүү нь гурав дахин болон түүнээс бага бол A, 12 дахин илүү болон түүнээс дээш бол F үнэлгээ өгсөн байна.Судалгааны үр дүнгээс харахад ерөнхий зориулалттай хиймэл оюуны загваруудаас нэг нь ч A үнэлгээ авч чадсангүй. Жишээ нь, Google-ийн Gemini болон Gemma загваруудын хамгийн өндөр, хамгийн бага токены хэрэглээ 5.1 дахин зөрүүтэй гарч, B үнэлгээ авчээ. Anthropic-ийн Claude загваруудын хувьд 9.3, Meta-ийн Llama 4 загварын хувьд 9.5 дахин зөрүүтэй байв. Харин OpenAI-ийн GPT-5 загварын хамгийн их болон бага токены хэрэглээ 13.8 дахин зөрүүтэй гарснаар F үнэлгээ авсан байна. Хамгийн өндөр зөрүү нь Falcon 3 загварт илэрч, 17 дахин зөрүүтэй гарчээ.
Нөгөөтээгүүр, бүх хэлд зориулан тусгайлан хөгжүүлсэн технологи ямар үр дүнд хүрч болохыг Meta-ийн NLLB-200 орчуулгын загвар харуулав. Уг загварын хэл хоорондын хамгийн их зөрүү ердөө 2.7 дахин байсан бөгөөд судалгааны A үнэлгээ авсан цор ганц хиймэл оюуны загвар болжээ. Мөн нийт 203 хэл-бичгийн хувилбараас 194-ийг нь хамгийн үр ашигтай хэлтэй харьцуулахад хоёр дахин болон түүнээс ч бага токены зөрүүтэй боловсруулсан байна. Гэхдээ энд нэг зүйлийг санууштай нь NLLB-200 нь орчуулгын зориулалттай тул GPT-5, Gemini зэрэг олон төрлийн даалгавар гүйцэтгэдэг бусад загвартай шууд адилтгах боломжгүй.
ТЭГВЭЛ МОНГОЛ ХЭЛНИЙ ХУВЬД?
CLEAR-ийн судалгаанд ашигласан FLORES-200 өгөгдлийн санд кирилл бичигтэй халх монгол хэл багтсан боловч нийтлэгдсэн тайланд монгол хэлний токены хэрэглээг тусгайлан авч үзээгүй байлаа. Харин GitHub дээр нийтлэгдсэн “Tokenizer Efficiency Across Languages” нэртэй бие даасан туршилтаар монгол хэлний токены хэрэглээг англи, орос, япон, чех хэлтэй харьцуулжээ. Судлаач бус бие даан туршилт хийсэн хөгжүүлэгч FLORES-200 өгөгдлийн сангийн ижил утгатай 200 өгүүлбэрийг зургаан өөр токенчлолын системээр боловсруулсан байна.
Үр дүнд нь монгол хэл туршилтад хамрагдсан зургаан системд бүгдэд нь хамгийн олон токен шаардсан хэл болжээ. Тухайлбал, GPT-4 загварын токенчлолын систем дээр англи хэлээс 3.74 дахин, GPT-4o дээр 1.91 дахин олон токен хэрэглэсэн байна. Мөн Llama 3 загварын токенчлолын систем дээр 3.15 дахин олон токен шаардсан бол олон хэлний орчуулгад зориулсан NLLB-200 дээр энэ зөрүү 1.39 дахин байжээ.
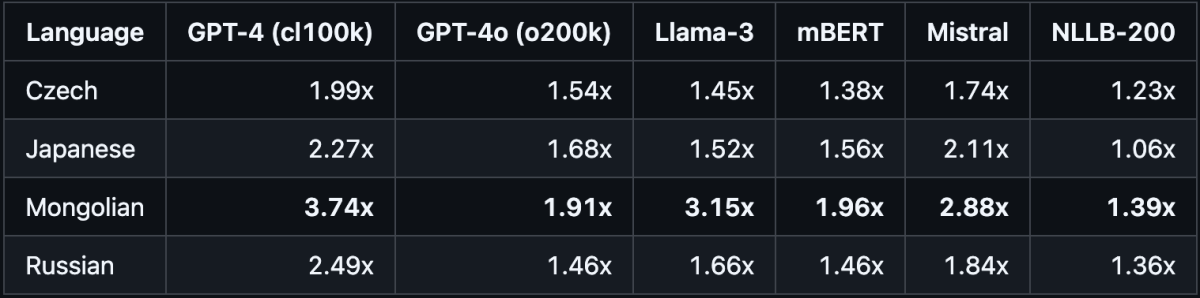
Энэ үр дүнг CLEAR-ийн албан ёсны судалгаанаас тусдаа, ердөө 200 өгүүлбэрт тулгуурласан туршилт учраас бүх төрлийн монгол текстэд ижил харьцаа үйлчилнэ гэж дүгнэх боломжгүйг анхаарууштай.
Манай монгол хэл үгийн язгуурт олон дагавар, нөхцөл залгаж утга илэрхийлдэг бүтэцтэй тул эдгээр онцлогийг хиймэл оюуны загварууд хэр үр ашигтай боловсруулж байгааг цаашид нарийвчлан харьцуулах нь чухал байна.
ТОКЕНЫ ХЭРЭГЛЭЭГЭЭ ЯАЖ ШАЛГАХ ВЭ?
Хиймэл оюунд бичсэн өгүүлбэр хэдэн токен болж хуваагдаж байгааг хэрэглэгч өөрөө шалгаж болно. OpenAI-ийн Tokenizer хэрэгсэлд дурын өгүүлбэр оруулж, тухайн текстийг токенчлолын систем хэрхэн хувааж буйг харах боломжтой.
Үүнийг туршихын тулд “Хиймэл оюун бидний өдөр тутмын ажлыг хөнгөвчилж байна” гэсэн өгүүлбэрийг монгол болон англи хэлээр бичээд, ижил токенчлолын системээр харьцуулж үзэв.
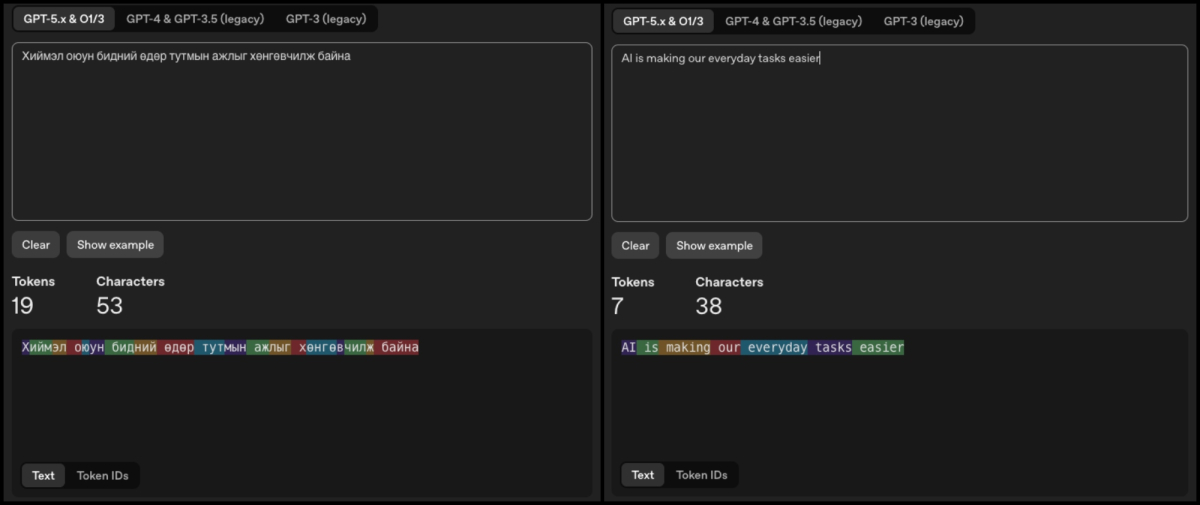
Гэхдээ ганц өгүүлбэрийн үр дүнгээр тухайн хэлний нийт токены хэрэглээг дүгнэж болохгүй. Найдвартай харьцуулалт хийхийн тулд олон төрлийн текст, хангалттай хэмжээний өгөгдөл ашиглах шаардлагатай. Уншигч та нийтлэлийнхээ дараа олон янзын туршилт хийж үзээрэй.
ТЭГВЭЛ ТОКЕНОО ХЭРХЭН ХЭМНЭХ ВЭ?
Токен хэмнэх хамгийн энгийн арга нь хиймэл оюунд илгээж буй мэдээллээ оновчтой болгох явдал. Гэхдээ асуултаа аль болох богино бичлээ гээд асуудал шийдэгдэхгүй. Харин шаардлагатай мэдээллээ тодорхой өгч, илүүдэл өгүүлбэр, давхардсан зааврыг багасгах нь чухал.
1. Асуултаа тодорхой, товч бичих
Хэт ерөнхий, нуршуу заавар өгөхийн оронд хүсэж буй үр дүнгээ тодорхой илэрхийл. Жишээлбэл, “Маркетингийн талаар дэлгэрэнгүй тайлбарла” гэхийн оронд “Жижиг бизнест тохирох маркетингийн гурван аргыг тайлбарла” гэж асуувал оновчтой.
2. Хариултын хэмжээг урьдчилан заах
“100 үгт багтаа”, “Таван өгүүлбэрээр тайлбарла”, “Гол гурван санааг гарга” гэх мэт заавар өгснөөр шаардлагагүй урт хариулт авахаас сэргийлж, гаралтын токеноо хэмнэнэ.
3. Харилцан яриагаа цэгцлэх
Урт харилцан яриа, давтагдсан мэдээлэл токены хэрэглээг нэмэгдүүлдэг. Тиймээс сэдэв солигдоход шинэ харилцан яриа эхлүүлэх, урт баримт бичгээс зөвхөн шаардлагатай хэсгийг оруулах нь зүйтэй.
4. Тохирох загвараа сонгох
Хамгийн хүчирхэг загвар үргэлж хамгийн үр ашигтай байдаггүй. Энгийн даалгаварт хөнгөн загвар ашиглаж, токены үнэ, хариултын чанар, гүйцэтгэх хурдыг харьцуулан сонгоорой.
5. Давтагддаг мэдээллийг дахин боловсруулахгүй байх
Хиймэл оюунд өмнө боловсруулсан мэдээллийг түр хадгалж, дахин ашиглах prompt caching гэх технологи бий. Жишээлбэл, байгууллагын чатбот хэрэглэгч бүрд хариулахдаа үйлчилгээний ижил мэдээлэл ашигладаг. Ийм үед prompt caching технологиор өмнө боловсруулсан мэдээллийг дахин ашиглаж, хиймэл оюуны үйлчилгээний зардлыг бууруулах боломжтой.
ИНГЭХЭД БАГА ТОКЕН АШИГЛАХ НЬ САЙН ГЭСЭН ҮГ ҮҮ?
Хиймэл оюуны хэрэглээгээ оновчтой болгохын тулд хамгийн түрүүнд нэг зүйлийг ойлгох хэрэгтэй. Токены тоо бага байх нь заавал илүү сайн, чанартай хариулт авна гэсэн үг биш юм. Тухайлбал, хиймэл оюунд хэт богино, тодорхойгүй заавар өгснөөр хүссэн үр дүнгээ авч чадахгүй бол дахин асуулт асуух, хариулт засварлуулах, мэдээлэл нэмж өгөх шаардлага үүснэ. Энэ нь анхнаасаа сайн боловсруулсан нэг заавар өгөхөөс ч олон токен зарцуулж болзошгүй.
Нөгөө талаас токены үнэ буурч байгаа нь хиймэл оюуны хэрэглээний зардлыг аажмаар хямд болгож байна. Гэхдээ CLEAR-ийн судалгаанд дурдсанчлан нэг сая токены үнэ хямдарлаа гээд хэл хоорондын боловсруулалтын ялгаа өөрөө арилна гэсэн үг биш ажээ. Тиймээс хиймэл оюуны загвар хөгжүүлэгчид олон хэлний онцлогийг харгалзан системээ сайжруулах, токены хэрэглээ болон зардлыг ил тод мэдээлэх шаардлагатай хэвээр байгаа юм.
Харин хэрэглэгчдийн хувьд өнөөдөр хийж болох энгийн алхам нь асуулт, заавраа илүү тодорхой болгох, шаардлагагүй мэдээллийг багасгах, хүссэн хариултынхаа хэлбэрийг урьдчилан зааж өгөх, хэрэглэж буй загварынхаа онцлогийг ойлгох явдал юм.

 Сэтгэгдэл бичих